
Cuando lanzas un sistema o implementas una nueva infraestructura tecnológica, los primeros 30 días son críticos. Es el momento de validar que todo funciona, encontrar fallas tempranas y establecer una base de monitoreo sólida para evitar sorpresas más adelante. Aquí tienes una lista de verificación práctica para guiar ese proceso con Ness.
1. Monitoreo básico de salud del sistema
Estas métricas son el “mínimo viable” para conocer el estado general de tus servidores y sistemas:
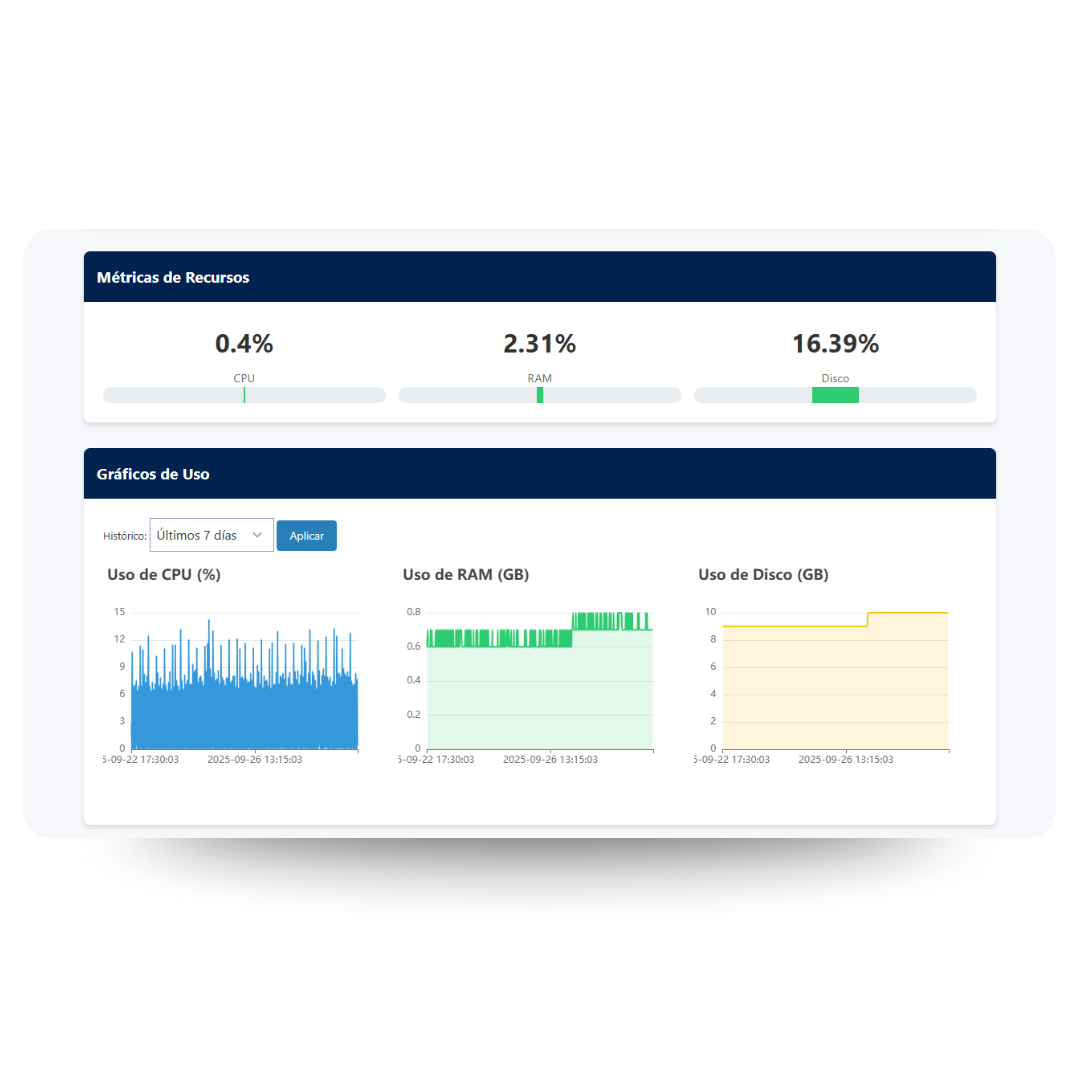
CPU: uso promedio, picos, procesos que consumen excesivamente
Memoria (RAM): uso, swapping, fugas de memoria
Uso de disco / IOPS: porcentaje usado, latencia, espacio libre crítico
Temperatura / condiciones físicas (si aplica, en servidores on-premises)
Estado del sistema operativo / logs de errores críticos
Estado de los procesos y servicios esenciales (por ejemplo, bases de datos, servidores web, colas)
2. Disponibilidad (Uptime) y latencia
Ping / ICMP: asegurarte de que los hosts estén accesibles
Monitoreo de puertos / servicios esenciales: HTTP(S), SSH, base de datos, APIs
Tiempos de respuesta (latencia): cuánto tarda cada servicio en responder
Verificación de endpoints críticos (por ejemplo, rutas de API, páginas clave)
3. Monitorización de red
Uso de ancho de banda: entrada, salida
Errores en interfaces de red, paquetes descartados
Latencia de red interna entre subsistemas
Conectividad entre componentes clave (microservicios, bases de datos, colas)
4. Certificados y dominios
Vigencia de certificados SSL / TLS
Estado DNS (resolución correcta)
Disponibilidad del dominio / subdominios
Velocidad de subida / bajada si aplicable
5. Alertas y notificaciones
Configura alertas tempranas (antes de que el sistema falle)
Define umbrales sensatos (por ejemplo, 80 % CPU, menos de 10 % de disco libre)
Configura canales de notificación (Telegram, WhatsApp, Slack, correo, etc.) — Ness permite integraciones con múltiples canales según la documentación.
Prueba que las alertas realmente se envían y que los destinatarios las reciben
Define escalamientos: quién responde si no se atiende una alerta inicial
6. Vulnerabilidades y seguridad básica
Escaneo de vulnerabilidades público e interno (NESS soporta este tipo de escaneo según su página)
Revisión de parches del sistema operativo y dependencias de software
Verificación de accesos no autorizados o logs de seguridad
Autenticación y permisos: asegúrate de que los servicios no tienen privilegios excesivos
Revisar puertos expuestos públicos innecesarios
7. Integridad y consistencia de datos
Monitoreo de backups: que se estén generando correctamente
Revisión de logs de errores de base de datos
Verificación de latencia de replicación (si aplica)
Chequeos de consistencia interna (por ejemplo, en colas, sistemas replicados)
8. Comportamiento y crecimiento
Tendencias de uso: consumo de recursos día a día
Crecimiento de logs / almacenamiento
picos de tráfico inesperados
Patrones de uso en diferentes momentos del día
9. Experiencia del usuario / monitoreo funcional
Monitoreo de endpoints críticos desde la perspectiva del usuario final
Transacciones clave: inicio de sesión, pagos, consultas importantes
Verificación de integraciones con terceros (APIs externas)
10. Revisión y ajuste continuo
Revisar alertas falsas o “ruido” y ajustar umbrales
Validar que los informes/resúmenes diarios o semanales son útiles
Reunir retroalimentación del equipo de operaciones / soporte
Documentar incidencias recibidas y cómo fueron detectadas
Planear mejoras: nuevas métricas, dashboards adicionales
Sugerencia de cronograma por semanas
| Semana | Enfoque principal |
|---|---|
| 1 | Configurar monitoreo básico de salud, disponibilidad y alertas iniciales |
| 2 | Agregar monitoreo de red, certificados, dominios y seguridad básica |
| 3 | Iniciar escaneos de vulnerabilidades, monitoreo funcional y backups |
| 4 | Analizar tendencias, ajustar alertas, preparar reportes automáticos |
Cómo Ness facilita este proceso
Ness ofrece monitoreo de hosts, servicios, puertos, dominios, integración con múltiples canales de notificación (Telegram, WhatsApp, Slack, etc.)
Cuenta con funciones de escaneo de vulnerabilidades públicas e internas.
Su diseño “all-in-one” permite centralizar en una única interfaz lo que de otro modo requiere múltiples herramientas.
Su agente ligero y la comunicación segura (TLS 1.3) permiten recolectar telemetrías de forma eficiente.
Consejos finales
No esperes detectar todo en el primer mes; prioriza lo crítico y expande progresivamente.
Empieza con alertas conservadoras, pero que te adviertan antes del fallo.
Involucra a tu equipo de operaciones / soporte desde el inicio: su experiencia operativa te dirá qué métricas importan.
Automatiza lo más que puedas: generación de reportes, alertas, dashboards.
Documenta todo: configuración de umbrales, justificaciones, casos de uso, lecciones aprendidas.